LTT
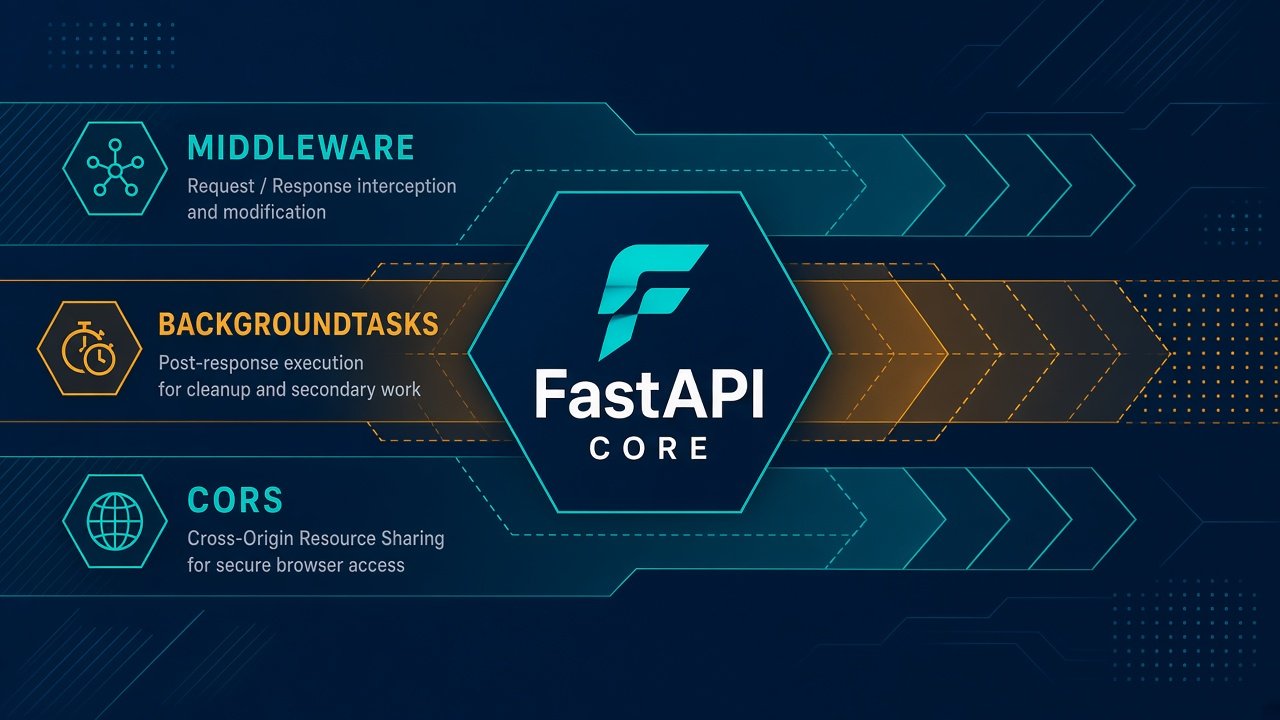
中间件、CORS 和后台任务分别解决什么
FastAPI 三大中间件需分层使用:自定义中间件处理全局请求流(如记请求ID、计时、安全头),但不支持Depends注入的上下文;CORS中间件仅限浏览器跨源预检,需明确指定Origin列表,禁止用*搭配Cookie;后台任务(BackgroundTasks)处理响应后可丢失的轻量工作(如邮件、日志),需独立建立数据库会话。常见误区包括用中间件替代登录鉴权、混淆CORS策略导致浏览器拦截、后台任务依赖已关闭的DB会话。三层职责清晰划分可避免预检失败和资源泄漏,提升系统扩展性。正确分层使鉴权由Depends控制、CORS定向管理浏览器、后台任务异步处理非核心任务,兼顾安全性和开发效率。
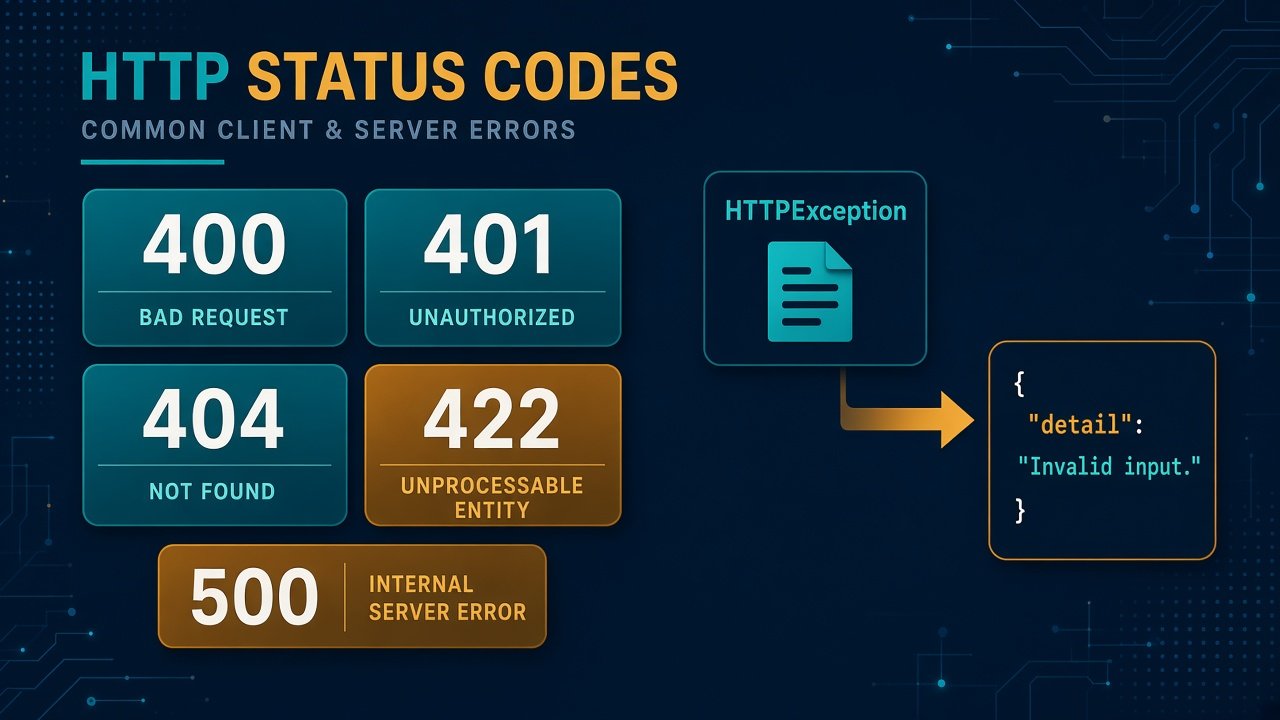
状态码和异常为什么不要裸 raise
FastAPI错误处理需遵循HTTP协议规范:应用层错误应通过HTTPException映射到对应状态码(如404/422),系统级错误保留500状态码。需使用422状态码处理Pydantic模型校验失败,避免混淆业务400错误。领域异常建议单独封装 Exception 并自定义handler映射到HTTP(404/409等),服务层与Web层解耦。禁止将内部日志或堆栈信息返回客户端,生产环境应关闭traceback。常见误区包括:用200包装错误导致监控失效;捕获异常后静默返回空对象;混淆404(资源不存在)和403(权限不足)。需注意401需搭配WWW-Authenticate头使客户端重认证,隐私敏感资源可统一用404避免信息泄露。正确实践确保协议兼容性与系统健壮性。
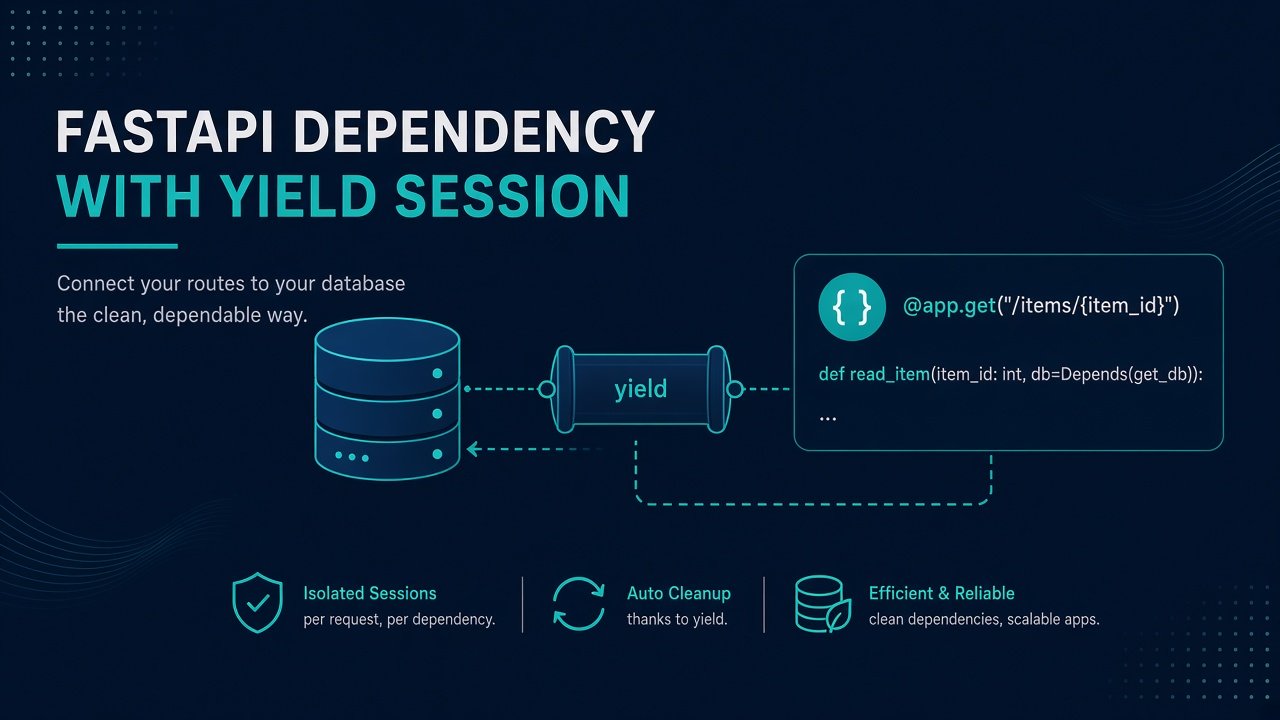
数据库会话怎么进接口:SQLAlchemy 与依赖覆盖
FastAPI数据库会话需通过依赖注入实现请求级隔离。核心方法:1.应用启动时配置数据库引擎 SessionLocal;2.路由使用db: DbDep依赖注入,成功路径自动提交事务,异常路径自动回滚;3.测试时通过dependency_overrides覆盖SessionLocal为内存会话实现隔离测试。关键注意事项:禁止使用全局会话导致并发污染,路由层代码仅负责增删改查逻辑不重复提交,确保连接字符串通过环境变量配置。同步模式下避免在async函数内使用同步驱动操作,异步模式需使用postgresql+asyncpg等特定协议引擎。此架构支持金字塔应用模式,满足90%常规业务场景需求,为后续实现乐观锁、审计追踪等高级特性奠定基础。
生产怎么部署:workers、健康检查、配置与日志
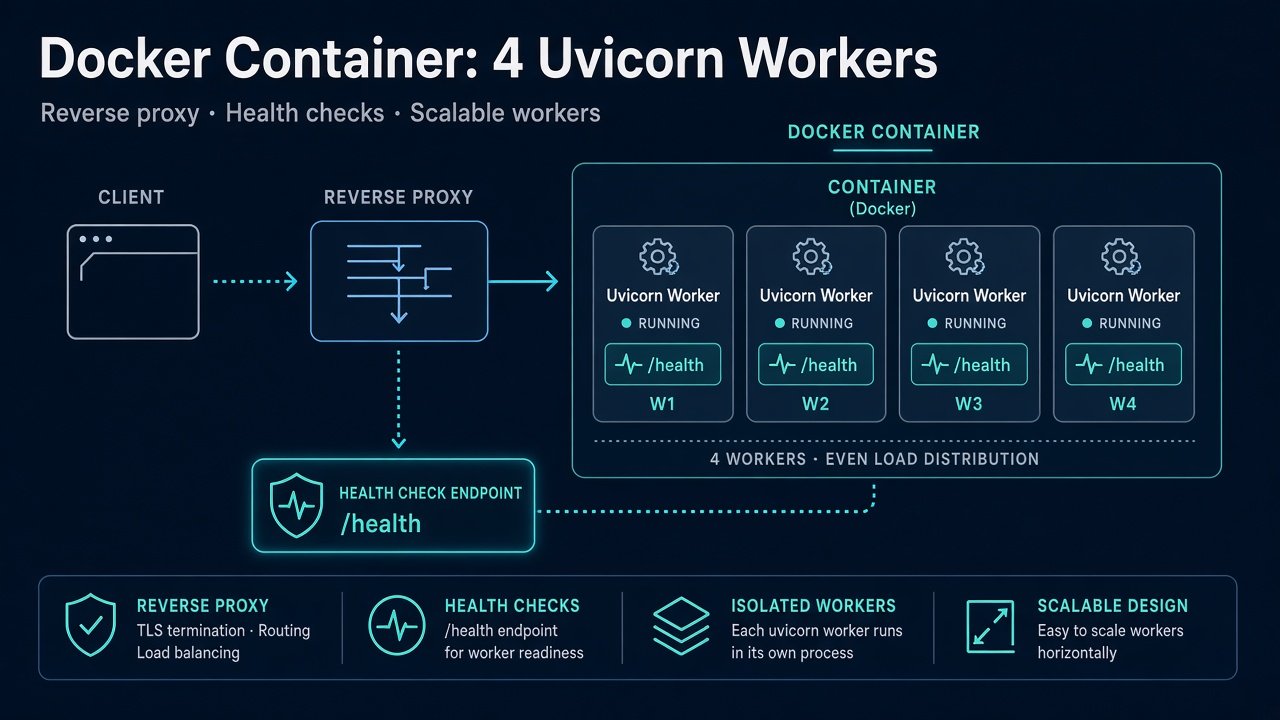
FastAPI生产部署需解决多worker进程扩容、自动探活、日志收集三问题。健康检查通过/health(静默检测)和/ready(数据库状态确认)端点实现,避免重量级操作。配置采用.pydantic模块读取环境变量,禁用调试文档提升安全性。Dockerfile需基础镜像精简,保持依赖仅需运行时环境,命令明确指向应用入口。常见误区包括:禁用热重载(避免文件监控性能损耗)、数据库与应用隔离部署、避免线程池硬扛阻塞调用。最终架构为无状态服务集群配合Uvicorn worker,通过标准日志流对接编排系统,形成完整的可部署生产链路。读者可掌握最小化配置、探活机制设计、容器化部署规范及性能瓶颈规避方法。
测试怎么写才不连真实库:TestClient 与 dependency_overrides
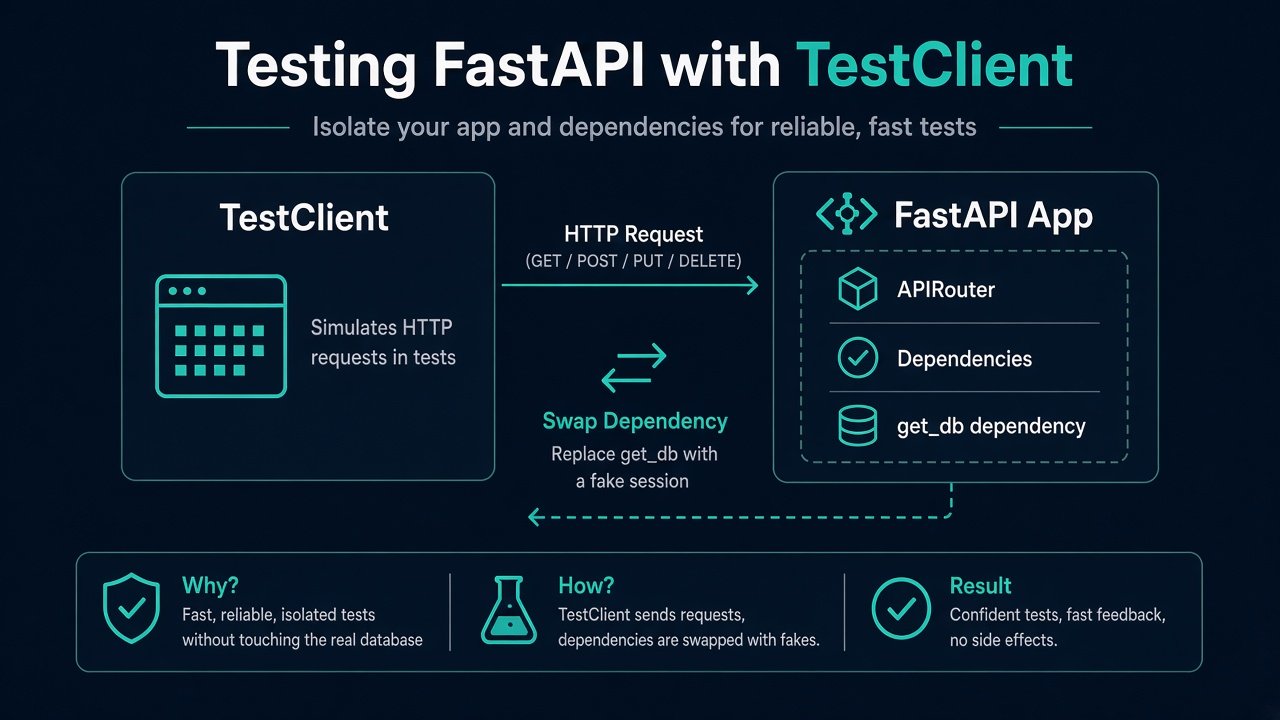
FastAPI接口测试需验证状态码、JSON结构及鉴权分支,而非检查数据库状态。使用TestClient模拟ASGI流程,推荐依赖替换而非真实环境启动,避免端口冲突及性能损耗。重点覆盖get_db、get_current_user等依赖函数的参数分支:1)用FakeSession模拟数据库依赖,通过dependency_overrides接收替换的函数对象,确保替换的是原始注入函数而非同名新函数;2)测试user分支时替换依赖函数构造单元测试,集成测试保留生产依赖;3)错误测试需覆盖契约约束修改,如GE422时的Pydantic字段验证失效。常见误区包括:在每个测试中重复初始化uvicorn服务、混淆测试层级导致集成测试coverage下降、暴露真实JWT密钥引发环境耦合。遵循分层测试原则:单元测试替换应用层依赖,仅通过API契约验证业务逻辑;生产部署测试才接触真实数据库及认证密钥,确保测试效率与代码健壮性。
依赖注入到底省了什么:Depends、yield 与生命周期
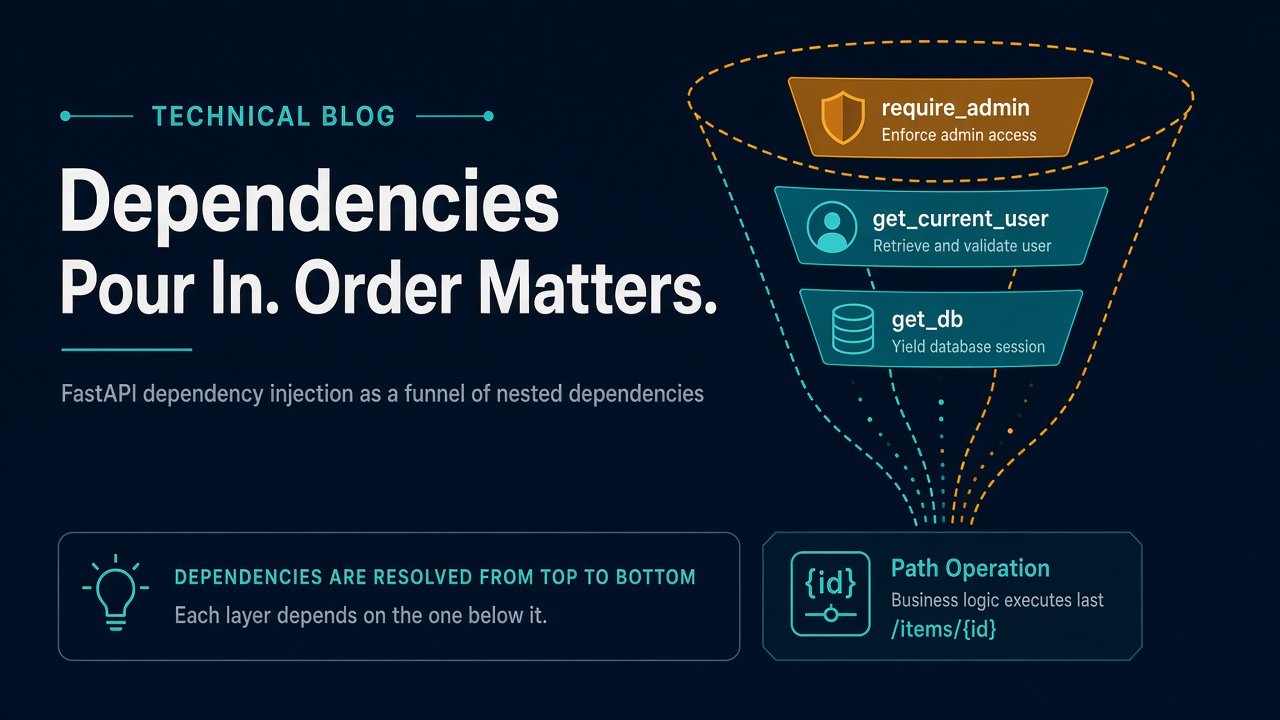
FastAPI 通过依赖注入分离请求处理逻辑,路径函数仅声明所需服务。每个依赖在请求开始时创建,完成后自动清理。支持 yield 实现类似 context managers 的行为,确保资源正确定位。例如:路由依赖通过 `Depends(get_settings)` 从外部获取配置,数据库会话通过内层依赖的 yield 机制保证生命周期管理。需注意依赖深度不宜超过三层,防止性能下降和理解困难。常见误区包括:全局数据库会话导致并发错误;滥用依赖埋抽象复杂性;忽略 yield 后异常自动回滚。正确实践能提升代码复用性、可测试性与调试效率,同时减少状态管理错误,为后续中间件和部署优化奠定基础。
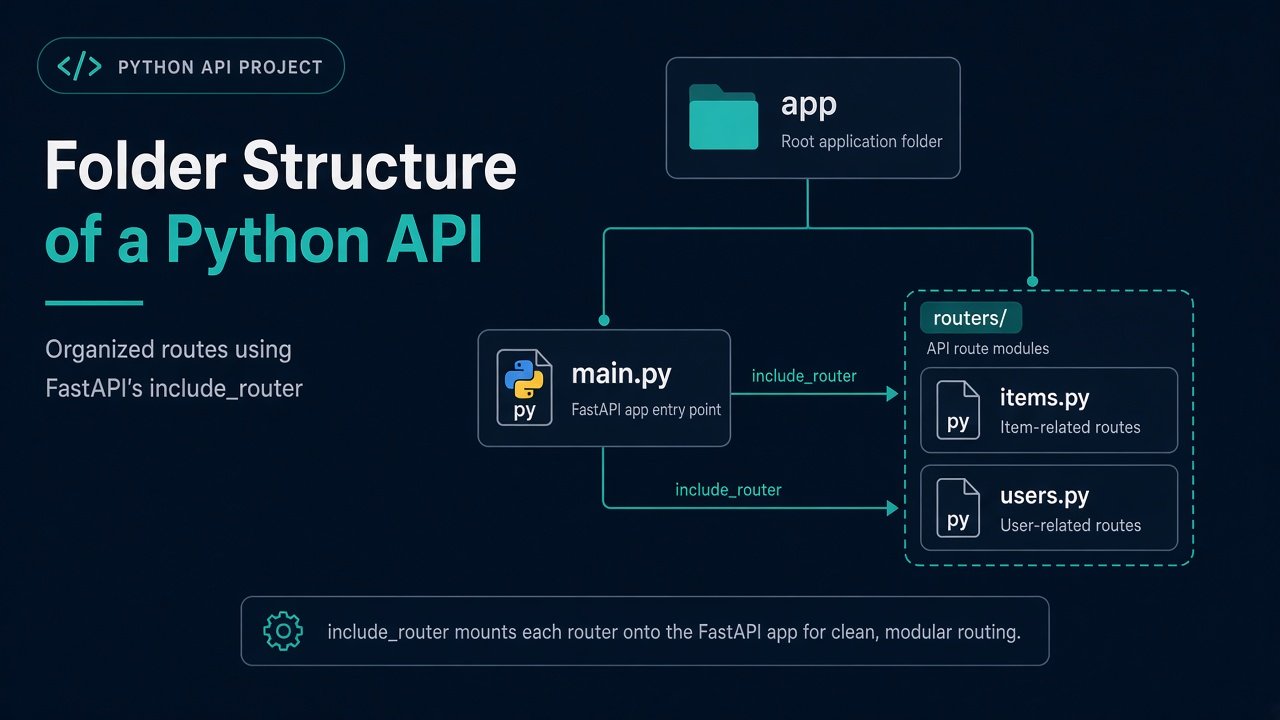
路由怎么拆:APIRouter、前缀和项目结构
FastAPI 应用应通过 APIRouter 合理拆分路由,解决代码复杂度问题。建议目录结构为 app/主文件/dependencies/Router子目录,每个路由文件内部专注业务逻辑。核心要点包括:1. APIRouter 灵活管理路径前缀、文档标签和依赖;2. 中间件、异常处理等公共逻辑归属主文件,路由函数需精简;3. 路由级依赖可整组生效,减少单个接口注解;4. 误区需规避重复路径、过度拆分(粒度以资源为单位)及错误的独立 App 实例创建。重要操作:路由注册时指定前缀(如)/api/v1,依赖注入作用于整个路由组而非单接口。实际开发中通过模块化提升维护性,避免将小型功能拆分子路由,确保功能边界清晰。
CrewAI 适合什么:角色、任务和 Crew 编排
这篇解决什么 CrewAI 解决的是「按角色分任务」的 Multi-Agent,不是通用图编排。核心对象只有三个:Agent(角色、目标、工具)、Task(要交付什么)、Crew(谁和谁、按什么流程跑)。原先这篇是空草稿,并进这一条,不再另开标题。 先写角色边界,再写 Crew 每个 Agent 只
LangGraph 管什么:State、边和人机协同
LangGraph 通过图结构系统性管理循环、分支、中断和恢复场景,核心包含共享状态(State)、可执行节点(Node)和条件边(Edge)。State以TypedDict实现多轮共享数据,Node定义模型/工具调用或状态修改,Edge区分固定路径和需模型决策的分支。相比LangChain的链式结构,LangGraph更适合需人工干预或多状态分支的流程。两种API互不混用,Graph API可视设计强,Functional API适配已有函数改造。执行时通过HITL机制(Human-in-the-loop)在tool调用前中断,记录检查点至内存外数据库(如PostgreSQL/Redis),确保恢复准确。流式执行需输出token级和节点级事件,避免内存存储导致会话中断。选型时:需可视化流程和中断恢复选LangGraph;仅需基础提示词+NLP/检索直接拼接 LangChain;角色分工场景建议CrewAI;需完整权限沙箱机制则参考AgentScope标准。
LangChain 提供什么:提示词、LCEL 与可组合组件
LangChain通过提示词、模型、检索器、工具等独立组件构建应用,而非提供完整产品。提示词需区分通用(填变量单轮调用)、Few-shot(固定示例保持格式语气)和ChatPromptTemplate(角色化消息链)三种类型,避免信息过载影响模型效果。核心在于LCEL(LangChain Element Layer)的组合机制,通过Runnable部件实现检索、上下文拼接、模型调用、结果解析的管道化流程,支持中间节点独立调试和流量控制,且保持与后续LangGraph(需图状态/HITL)和CrewAI(多代理协作)的系统扩展性。读者需根据需求选择:简单应用用本文方法,状态追踪选LangGraph,复杂的角色协作选CrewAI。特别指出RAGFlow专门处理文档权限闭环,避免用LangChain混用冒充平台功能。