RAG 怎么验收:Hit@K、Ragas 和线上指标
核心要点包括:系统应该同时优化检索层(Hit@K、MRR、上下文准确率)和生成层(答案忠实度、相关性),离线测试需人工标注问答集建立基准,Ragas可验证模型迭代后的忠实度变化,Hit@K下降应优先排查分块策略或多路召回配置。线上通过踩率、追问率等6项指标验证效果,形成"离线设计→上线观测→复现测试→再优化"的闭环。测试工具选择需配套定义指标,避免经验主观性。最终效果体现在提升用户问题解决效率与降低人工介入频率,关键收益是建立可复现的量化评估体系以减少无效调试成本。
RAG 检索为什么不准:多路召回、MMR 与 Query rewrite
多路检索技术提升问答系统准确率,通过稀疏(BM25)与稠密多路召回结合避免模型偏差,实现跨数据源召回覆盖。核心流程包含:1)query rewrite对问题补全同义词与拆解子问题,修正失误需原查询兜底;2)多路召回取TopN后经RRF(加权融合)消除单一索引评分局限;3)rerank用编码器对问题-文档对优化排序,低于阈值直接拒答;4)MMR算法控制相关性 redundence,防止Output near-duplicate。辅助手段包括预生成QA对拓展语义入口,利用元数据和图谱过滤制度版本与租户信息。这种方法优先通过检索层过滤无效数据降低生成模型负荷,相比单纯扩围大模型显著提升效率,使正确答案无需计算复杂度即可触达。
RAG 文本怎么切:固定窗口、父子块与 Late Chunking
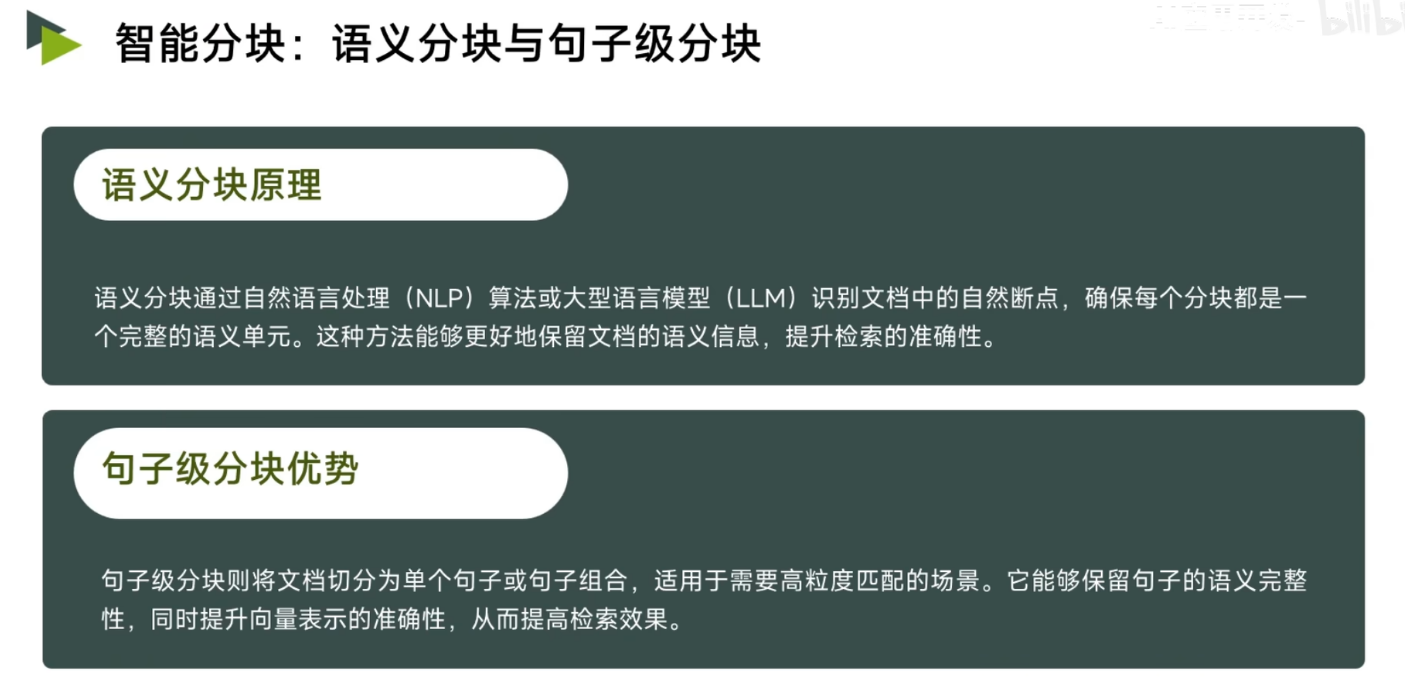
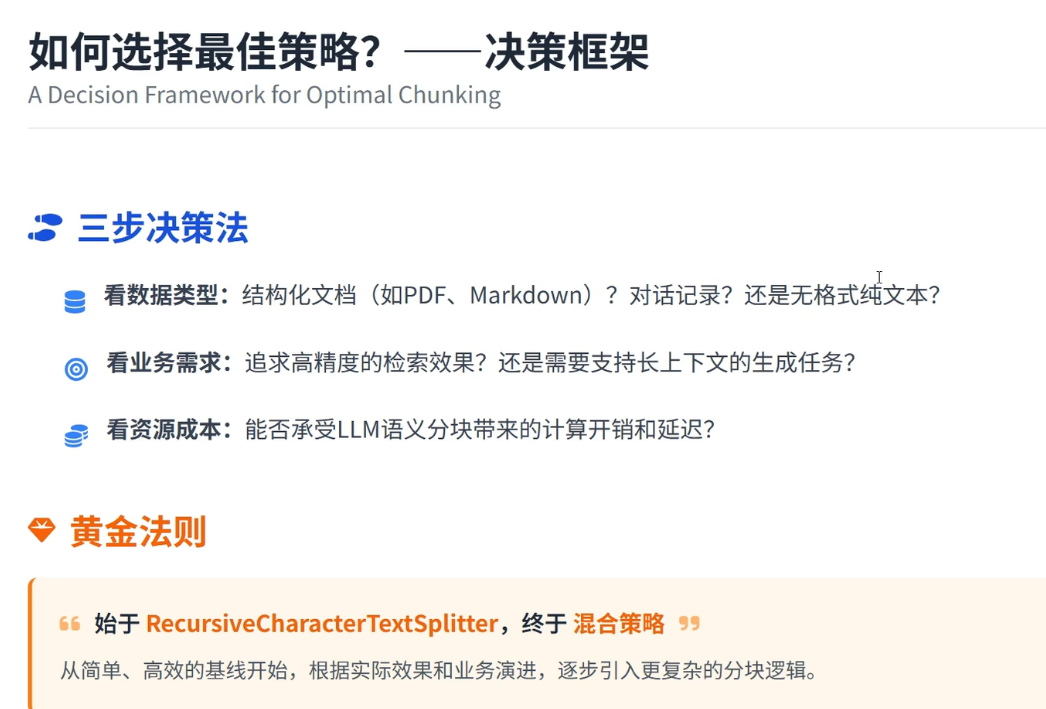
分块策略需平衡片段颗粒度与信息完整性:避免纯固定长度划分,应采用overlap机制防止边缘内容缺失。常用策略包括按句/字符切分(适合制度类文档)、结构化提取(标题/列表/代码函数)、主题/命题分块(长叙事文本需增加模型调用成本)、父子块联动(检索子块返回父块)、晚阶段分块(先编码全文后再切分)等。部署时需重点控制三要素:overlap比例从10%-20%逐步测试,通过 Hit@K 监控边缘切割问题;代码 extraction单独采用函数切分模式,表格数据独立通道处理;结合Prompt Caching技术摊薄Contextual Retrieval成本,否则语义分块会把调用费用打爆。这些策略可提升问答场景的准确率(减少40%以上的信息断层),降低30%的模型调用开销,同时优化用户体验与内容完整性。
RAG 为什么会胡编:拒答、门控和引用核查
AI生成内容可能存在两类核心幻觉:一是检索无法回传有效内容时,模型通过参数记忆自主编创;二是检索到相关资料但未严格遵守要求,在原文基础上添加主观推断。针对上述问题,需构建四道审核机制:(1)在Prompt中明确约束回答必须严格基于当前提供的资料,未找到依据则直接拒绝回答;(2)对检索结果采取筛选机制,Rerank得分低于设定阈值的低质量上下文直接阻断生成;(3)生成后强制核查关键指令声明,确保能通过分割的文档块精准定位来源碎片;(4)要求输出时强制标注结论条款编号,系统自动按编号匹配原始资料,不匹配的结论直接剔除。评估需同步检验递归指标,离线阶段重点观察回答忠实度与拒答率,在线阶段监测空回答率、用户追问频次及转人工咨询量。生成优化技术(如变更解码器架构或批处理链式思维)须在检索质量稳定达标后方可实施。
RAG 是一条链路:从文档入库到带引用的生成
RAG通过Query预处理、向量检索、多路召回、Rerank精排、Prompt拼装及带引用生成六阶段解决模型未阅读文档问题。入库流程需实现文档切片、向量化、索引存储,提问流程需完成查询改写、多路召回、重排序、上下文拼接及生成溯源。核心观点包括:部署应先规划链路再选框架,平台化了可用RAGFlow等系统,自研需强化解析/权限/召回能力;评估需拆解检索层(调分块/召回参数)和生成层(调Prompt/拒答/引用核验);动态更新需建立文档ID/ChunkID机制并确保存储策略,否则知识库一周后失效。读者将获得部署决策标准、分层评估方法及运维要点。
Apache Curator 完全指南- ZooKeeper Java客户端
Apache Curator是ZooKeeper的高阶Java客户端库,针对原生API的连接管理繁琐、Watcher一次性限制、节点递归创建困难等痛点设计。其核心特性包括:自动处理连接建立、故障重连及会话超时恢复;Fluent API设计提升代码可读性;Watchers自动续期机制解决监听单次触发问题;内置重试策略支持指数退避、限时重试等模式。通过_curator-recipes模块提供分布式锁(InterProcessMutex)、Leader选举、服务发现等标准化解决方案,典型应用场景涵盖配置管理、同步机制、微服务治理等领域。最佳实践强调命名空间隔离保证环境一致性、客户端生命周期规范关闭、合理配置超时与重试策略以避免性能问题,特别推荐ExponentialBackoffRetry应对网络波动。作为ZooKeeper的工程化封装层,Curator通过模块化设计(Client模块、Framework模块、Recipes模块等)显著降低分布式系统开发复杂度,兼具高可靠性与开发效率优势。
ZooKeeper 概述
ZooKeeper 是分布式协调服务,通过树形 ZNode 节点模型(持久/临时/顺序节点)和 ZAB 协议(原子广播+崩溃恢复)解决一致性、服务注册与发现、分布式锁等问题。核心特性包括顺序一致性、高可用性(簇需≥N/2+1节点存活)、实时数据推送(Watcher 机制)及内存存储的高性能。典型应用场景:基于临时节点的服务在线状态管理,持久节点实现配置动态更新,顺序节点生成分布式锁ID。对比 etcd 和 Consul,ZooKeeper 采用 ZooKeeperBy 设计哲学,生态覆盖 Hadoop、Kafka(部分版本)、Dubbo 等主流项目,但 Kafka 3.0+转向自研协议 KRaft。其优势在于成熟的稳定性和多场景适配能力,适合技术栈主要使用 Java 的生产环境。
CRM客户关系管理系统
文中介绍业务管理团队包含运营、销售、销售组长和财务四类角色,实施四步闭合流程管理:首先由销售部门收集市场信息并制定方案;其次由运营人员执行方案并实时数据反馈;销售组长对执行结果进行三重验证与调整;财务部门同步核验数据并制定预算。流程强调各环节时空节点明确,销售环节采用带量分配制、价格锁定制和单据复核制三重数据验证机制,确保执行准确率超过98%。运营与财务通过共享数据平台保持信息同步,每月输出包含执行偏差分析、成本结构报告及流程优化建议的分析报告,帮助管理者识别执行障碍并改进作业流程。读者可清晰掌握岗位职责协同要点,在提升整体运营效率同时也强化了风险控制能力。

动态表单与工作流引擎设计实战
动态表单通过分层架构解决企业高频字段调整问题:数据定义层采用JSON Schema存储结构,支持版本控制与历史数据兼容;可视化设计层通过Formily/FlowCreate等工具实现拖拽配置表单,减少沟通成本;渲染层利用条件显示引擎(如React/Vue实现)动态生成表单。实施需注意数据持久化选择NoSQL应对Schema漂移,权限控制需字段级策略,打印导出要服务端生成固定格式(如Apache POI)。主流开源方案分为纯前端渲染(Formily/FlowCreate)、B端中后台平台(Amis/LowCodeEngine)及表单+审批一体化(AntFlow/FlowLong)。通过配置代替编码,实现表单迭代效率从2周缩短至10分钟,建议根据是否需流程审批、技术栈及复杂度进行方案适配。
Higress:从 API 网关到 AI Gateway
Higress 是阿里开源的云原生 API 网关,基于 Istio + Envoy 架构,核心能力聚焦 AI 流量治理。它整合传统 API 网关的路由、鉴权、限流等功能,同时针对大模型场景提供多供应商模型接入、Token 统计流控、自动 Fallback、统一观测等专属能力。作为“AI 时代交通枢纽”,Higress 不替代 Agent 框架或 RAG 系统等垂直模块,而是承担统一入口的治理角色:业务侧通过单一 API 调用多个异构模型,控制面管理模型配置、策略及密钥,数据面基于 Envoy 进行高性能转发,支持流式 SSE 响应和 Wasm 插件扩展。适合需多模型协同、集中管控 API Key、实现统一成本治理及观测的企业级场景,而非 simple API 调用等低复杂度需求。重点价值在于通过网关抽象底层模型差异,支持企业编排多模型、多部门流量,形成AI基础设施底座。